COLUMN
AI活用レベルの決め方|大手とベンチャー30社の評価軸と、規模別の進め方
- 利用量だけを測った会社は、軒並み見直している。Duolingo は評価指標から外し、Shopify・Meta・Amazon は社内ランキングを廃止した。測る対象は「作ったもの」と「成果」に移っている
- 評価軸は4つのパターンに分かれ、大手とベンチャーでは効く進め方のパターンが違う。大手は段階を細かく定義して処遇につなぎ、ベンチャーはツールを配って期限付きの号令をかける。規模に合わないパターンをまねると手間だけが増える
- 段の文言を書く前に、何を測るか・処遇とどうつなぐか・いつどう直すかの3つを先に決める。評価軸は「決めるもの」ではなく「更新し続けるもの」として設計する
採用・組織人事のコンサルで200社以上、AI系ブティックファームで事業責任者。いまは AI 前提の組織設計を、自社で回しながらクライアントに提供している。
社員に生成AIのアカウントを配ってから半年。使う人と使わない人の差が、はっきり開いてきた。この差をどう測ればいいのか。人事評価に入れていいのか。同じ問いに、国内外の会社がすでに答えを出し始めています。DeNA は個人と組織を5段階で測り、Zapier は採用の足切りに使い、GMO は管理職にバッジ取得を義務づけました。一方で、Duolingo は AI の利用を評価指標に入れて、1年で外しました。この記事では、大手とベンチャーあわせて30以上の会社・団体が公開している「AI活用レベルの評価軸」を並べ、何を測り、何に使い、どこでつまずいたかを整理します。最後に、社員規模ごとにどの進め方のパターンが効くのかを表にまとめ、私たち Zeyra が自社で使っている評価軸も公開します。
- 社員に生成AIを配ったものの、使う人と使わない人の差が開いてきた経営者・人事責任者
- AIの活用度を人事評価や手当に入れるか、入れるならどうつなぐかで迷っている人
- 「AI推進」を任され、全社の現在地を測る物差しを作る必要がある担当者
- 従業員10〜300名で、大手の制度をそのまままねしてよいか判断がつかない人
- 大手・ベンチャー30社以上の「AI活用レベルの評価軸」を、4つのパターン(レベル定義/行動・試験・資格/ツール配布と号令/組織の成熟度)で整理した比較表
- 利用量で測った会社(Duolingo・Shopify・Meta)が1年以内に見直した理由と、何を測ると失敗しにくいか
- 社員規模別(〜10人から1000人〜)にどの進め方のパターンが効くかの早見表と、Zeyra が自社で使っている3つの評価軸(社員・業務・組織)
Webアプリ(無料・約10分。結果を見る前にお名前・会社名・メールアドレスを入力)
- 01 会社の規模と目的を答える(社員数・AIを測りたい理由)(約1分)
- 02 自社に合う進め方のパターンの提案(4つのパターンのどれから始めるか)(約1分)
- 03 社員のAI活用レベルを診断(Lv0〜5)(約2分)
- 04 業務のAI化ステージを診断(S0〜5)(約2分)
- 05 組織のAI成熟度を診断(O0〜5)(約2分)
- 06 結果と自社版レベル表のひな形(コピーして使える)(約2分)
| いま起きていること | 各社の答え | この記事で分かること |
|---|---|---|
| 使う人と使わない人の差が開いた | DeNA は個人5段+組織5段、GMO は S〜D の5段とバッジで測る | 4つのパターンのどれが自社に合うか(2章・6章) |
| 利用量で測ろうとしている | Duolingo・Shopify・Meta は1年以内に見直した | 量ではなく何を測るか(3章) |
| 人事評価に入れていいか迷っている | DeNA は直結させず、成果を半期評価で申告させる会社もある | 処遇とのつなぎ方と、規模別の順番(4章〜6章) |
| 基準を作っても古くなりそう | Zapier は1年で最低ラインを引き上げた | 更新し続ける評価軸の設計(7章・8章) |
01先に結論:うまくいっている会社は「量」を測っていない
調べて分かったことを、先に5つ挙げます。
- 利用量だけを測った会社は、軒並み見直しています。Duolingo は2026年4月に AI 利用を評価指標から外しました。Shopify・Meta・Amazon は社内の利用量ランキングを廃止しました。ランキングを上げるために、無駄に使う人が出たからです。
- 測る対象は「作ったもの」と「成果」に移っています。Zapier は2026年に、単発のプロンプトは最低ラインに届かないと基準を引き上げました。合格点は「繰り返し使える仕組みを持っていること」です。
- AIの効果の3分の2は、組織側で決まります。Microsoft の2万人調査では、組織要因が67%、個人要因が32%でした。1人だけ上手くても会社は進みません。
- 業績が業界平均を上回るのは「業務の作り直し」から。MIT の研究では、AI活用の第2段階から第3段階に上がるところで、成長率と利益率が平均を下回る側から上回る側に反転します。
- 大手とベンチャーでは、効く進め方のパターンが違います。大手は段階を細かく定義して処遇につなぎ、ベンチャーはツールを配って期限付きの号令をかけています。規模に合わないパターンをまねると、手間だけが増えます。
02評価軸は4つのパターンに分かれる
各社の取り組みは、見た目は違っても次の4つのパターンに分けられます(分類は Zeyra の整理です)。
| パターン | 何で測るか | 代表例 |
|---|---|---|
| A. 個人のレベルを定義するパターン | 個人を4〜6段階に分け、段階ごとの状態を定義する | DeNA、Zapier、GMO、NTTドコモソリューションズ、グッドパッチ |
| B. 行動・試験・資格で測るパターン | 行動の有無、試験や講座の修了で測る | Anthropic、LINEヤフー、サイバーエージェント、Ubie |
| C. ツール配布と号令でそろえるパターン | ツールを配り、使い方のルールや期限で行動をそろえる | ソフトバンク、LINEヤフー、スイッチメディア、Buffer |
| D. 組織の成熟度を測るパターン | 会社やチームの段階を測る | DeNA(組織)、MIT CISR、Gartner、Microsoft |
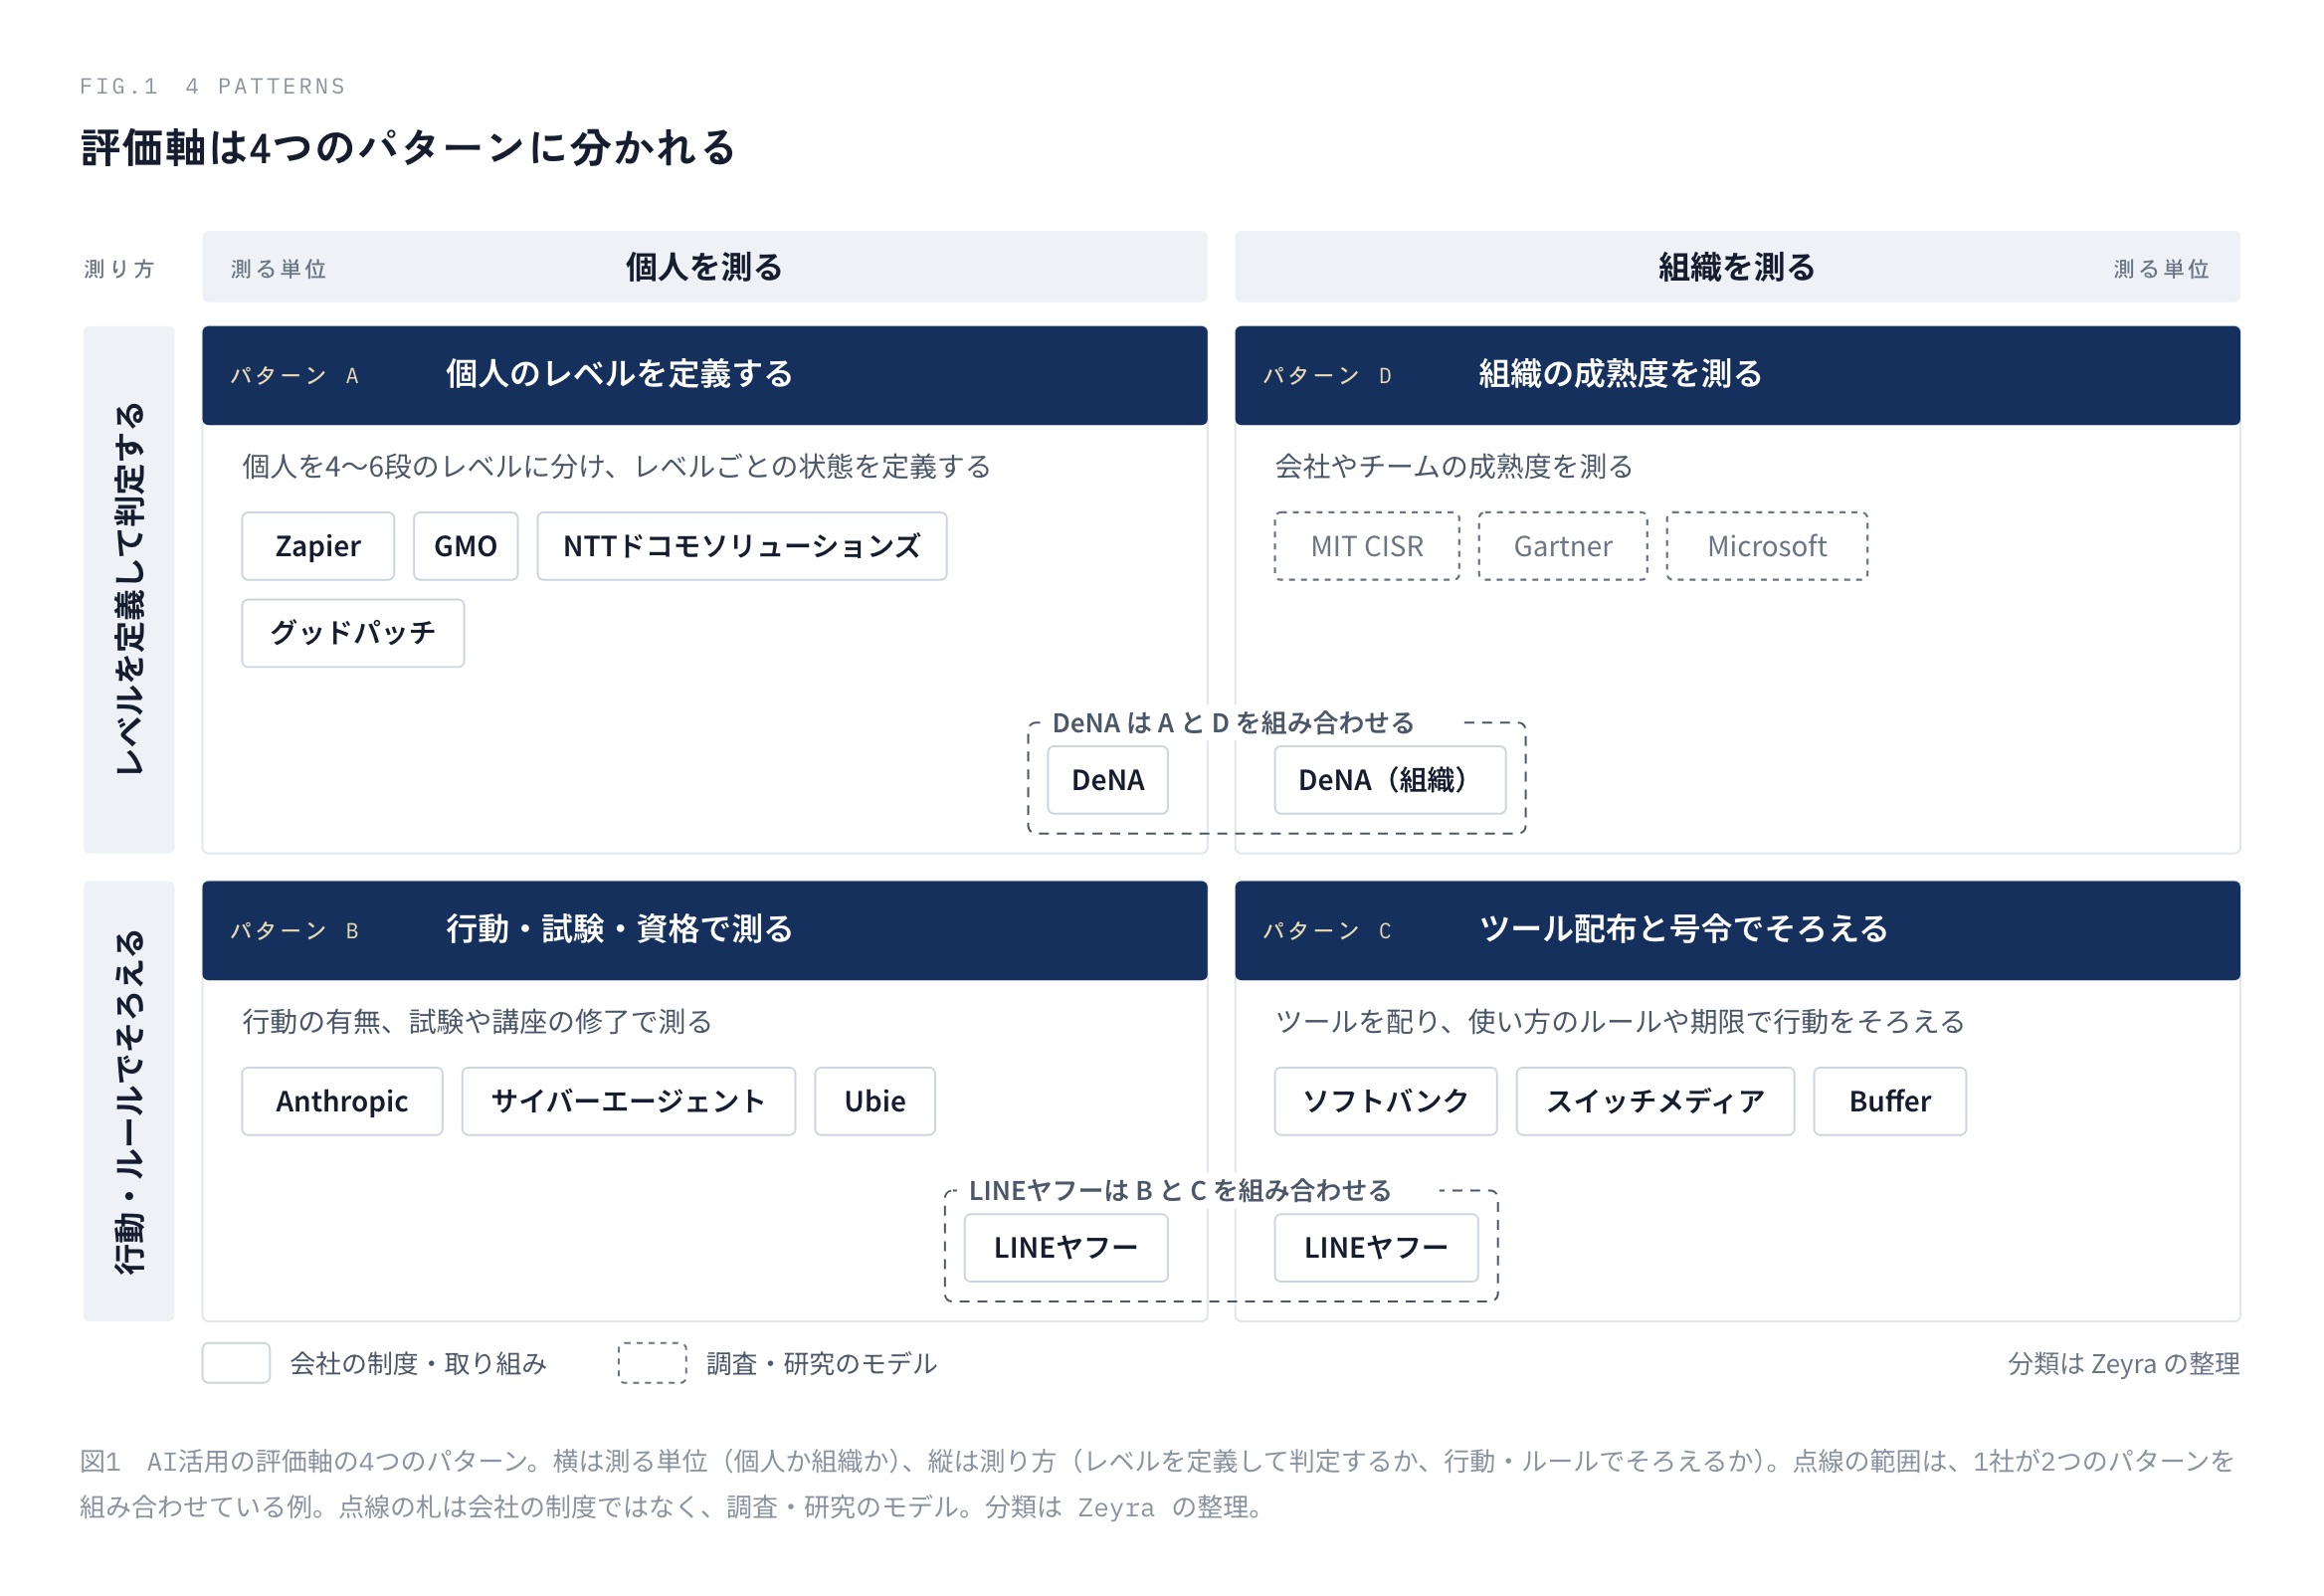
1つのパターンだけで済ませている会社は少なく、DeNA は A と D、LINEヤフーは B と C のように組み合わせています。
03何を測るかで、成否が分かれる
評価軸の設計で一番大きな分かれ道は、「何を見て判定するか」です。
| 測るもの | 例 | 良いところ | 落とし穴 |
|---|---|---|---|
| 使った量 | ソフトバンク「1人100個のエージェント」、Shopify・Meta の旧ランキング | 自動で数えられる。最初の一歩を全員に踏ませる | 数字稼ぎが始まる。使われない成果物が残る |
| 行動の質 | Anthropic の4D、Zapier の実技観察 | 上手に使えているかが分かる | ログで見えない行動がある |
| 作ったもの | Zapier(引き上げ後の基準)、NTTドコモソリューションズ、freee | 証拠が残る。ごまかしにくい | 作る仕事が得意な職種に有利 |
| 成果・影響 | メルカリ、Meta(ランキング廃止後) | 目的と手段を取り違えない | AIのおかげかを切り分けにくい |
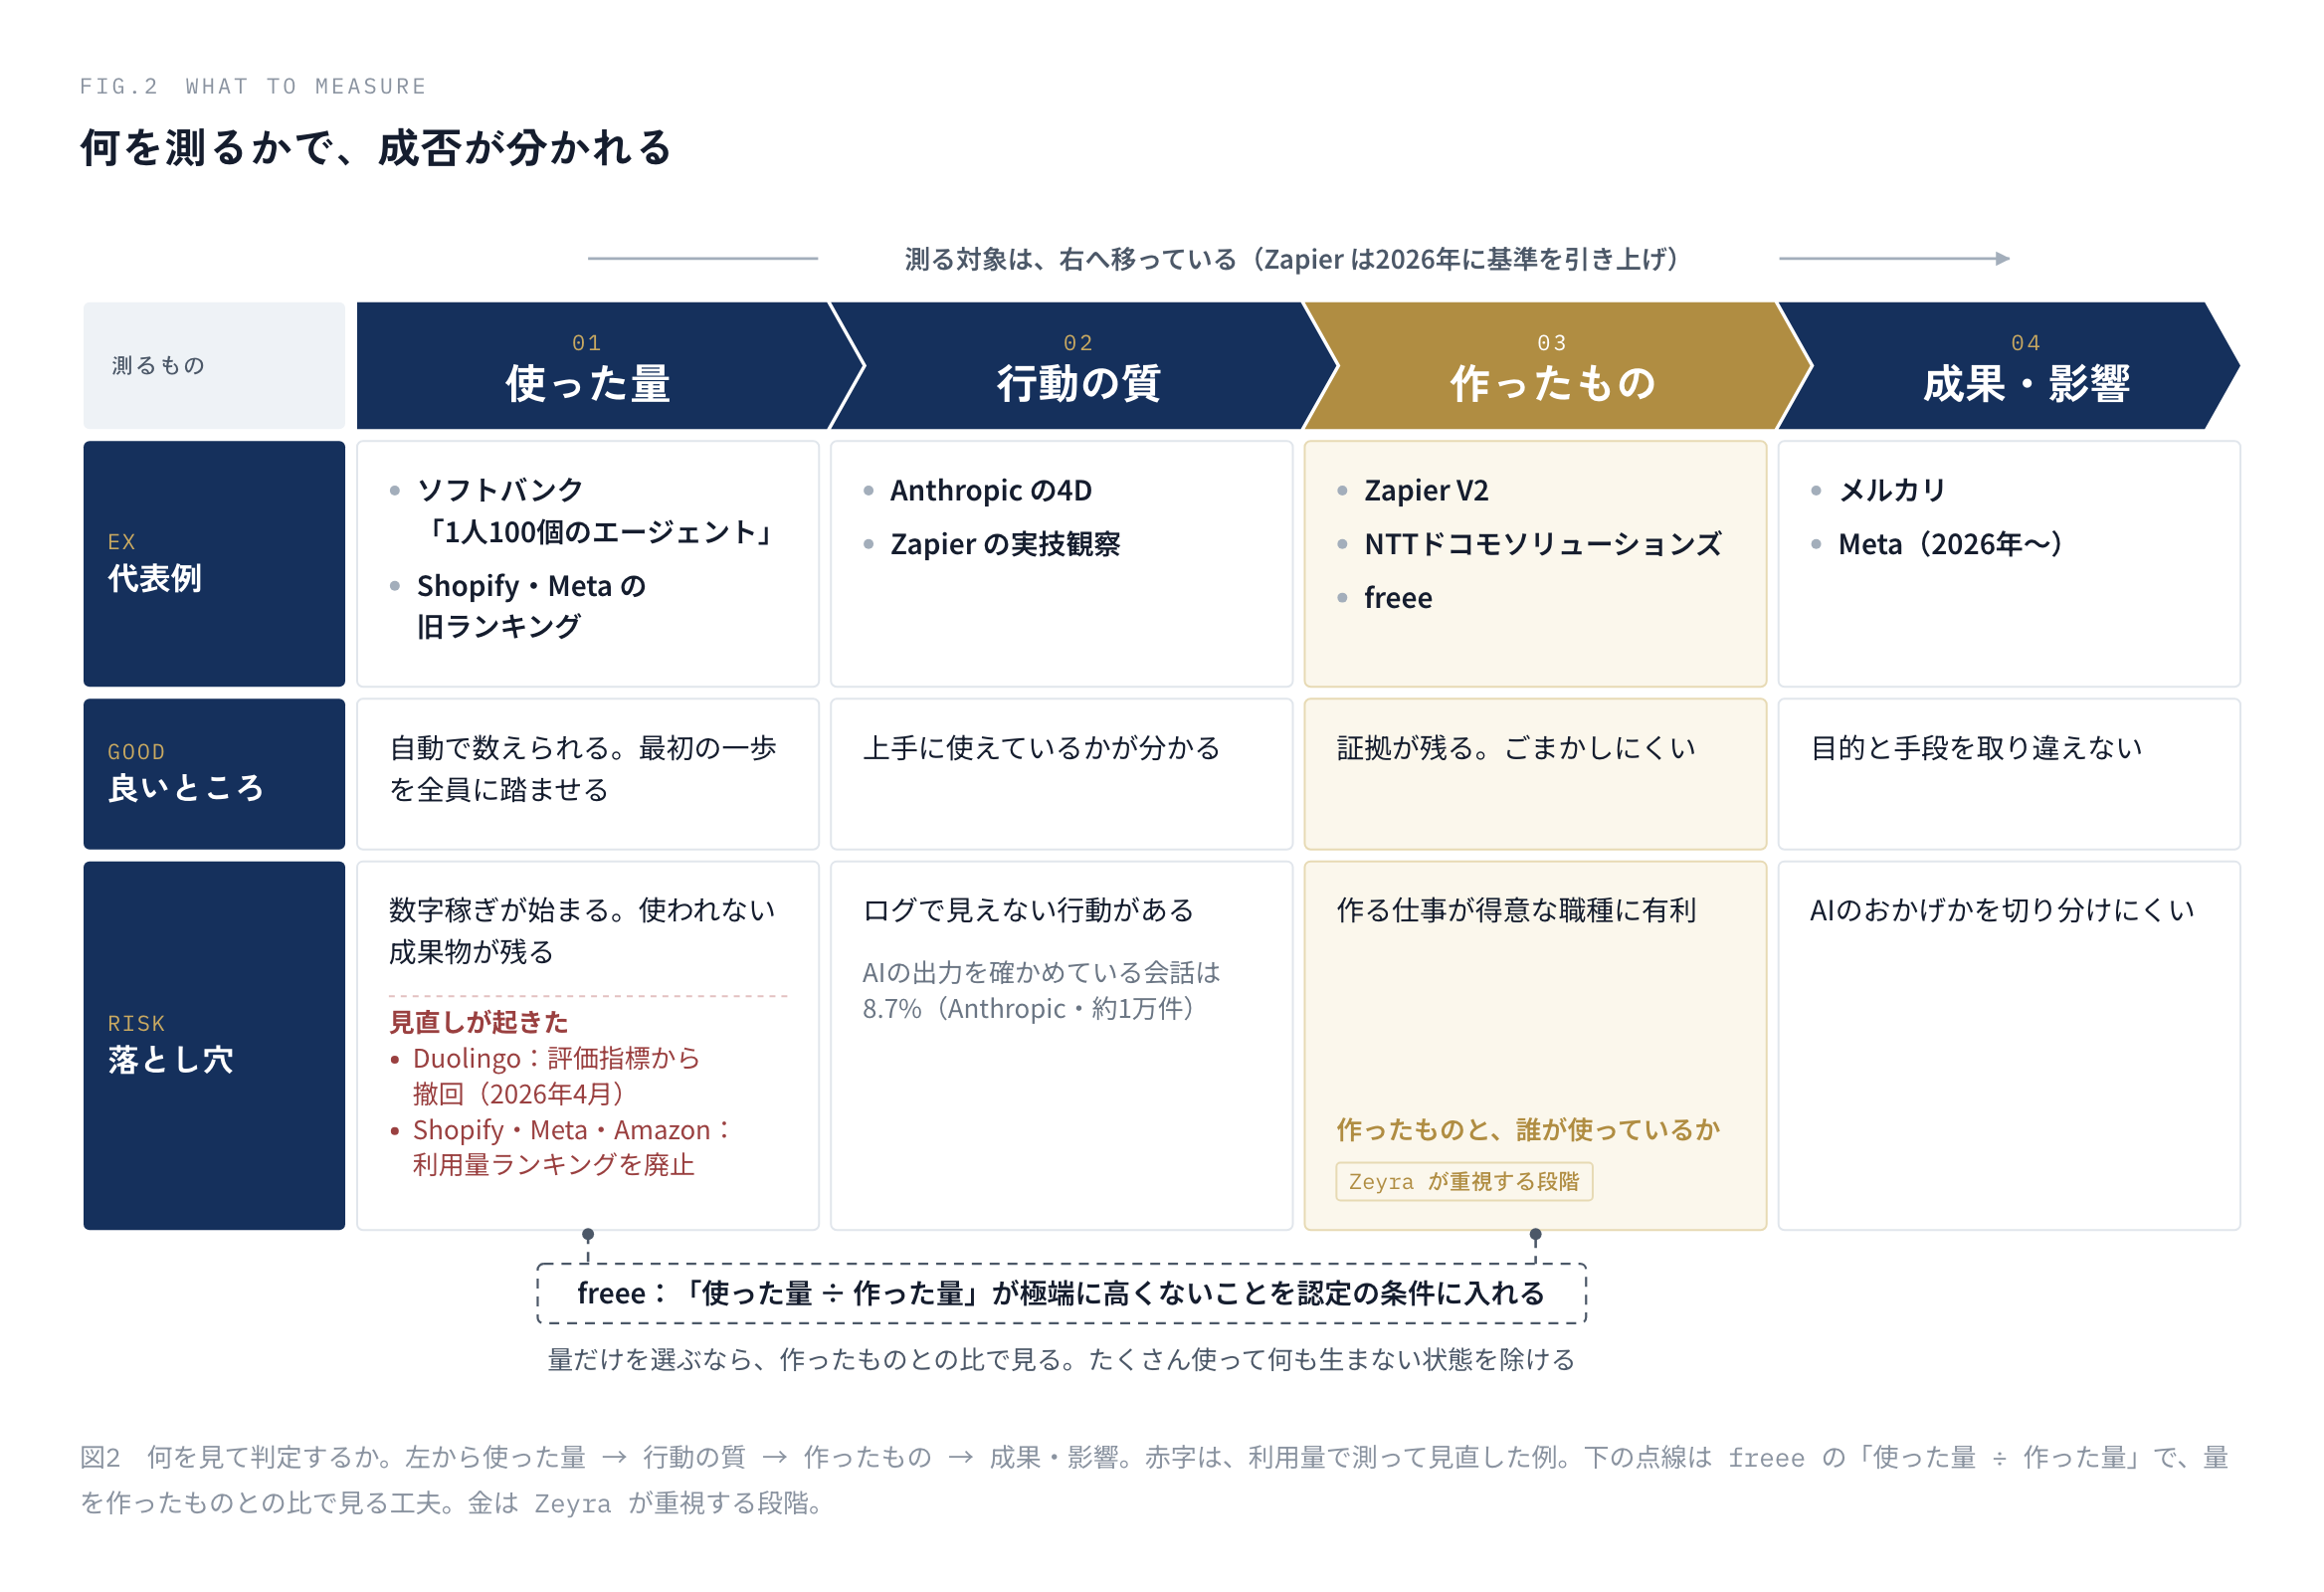
量を使いたいなら、freee のやり方が参考になります。freee は開発組織で「AI開発マニア」を認定する条件に、使った量と作った量に加えて、「使った量÷作った量」が極端に高くないことを入れました。「トークン量÷PR が極端に高すぎない」たくさん使っているのに何も生んでいない状態を除けるので、ランキングのような数字稼ぎが起きにくくなります。
もう1つ、見落とされがちな点があります。Anthropic が Claude の会話約1万件を調べたところ、AIの出力の事実確認をしている会話は 8.7% だけでした。しかも、AIに文書やコードを作らせる会話ほど、確かめる行動が減っていました。レベルが上がるほど、確かめる力は放っておくと落ちるということです。どのパターンを選ぶにしても、確認と責任は全レベルの条件に入れておくべきです。
04大手はどう測っているか
各社の公開情報(2026年10月時点)から、段階・判定・処遇の3点で並べます。
| 会社 | 段階 | 判定 | 評価・給与との関係 |
|---|---|---|---|
| DeNA | 個人5段(開発者/非開発者で別定義)+組織5段 | 本人と上長のすり合わせ(半期) | 直結させない。等級ごとの推奨要素 |
| Zapier | 4段(Unacceptable〜Transformative) | 採用でAIを使う様子を観察 | 採用の足切り |
| GMO | S〜Dの5段+社内テスト+バッジ | 試験・講座修了 | 管理職はバッジ必須。ランクは人事制度に組み込む予定 |
| サイバーエージェント | 全社員は講座修了、エンジニアは5段 | 自己評価アンケート(3か月ごと)「当社独自の基準で5段階に策定」 | 未公表 |
| NTTドコモソリューションズ | 帯(ベルト)4段 | 実績の書類審査をAIが行う | 上位者に認定証、社内で氏名公開 |
| LINEヤフー | 段なし | 試験合格が利用の条件 | インセンティブも罰則もなし |
| メルカリ | 非公開 | 半期評価で「AIで出した成果」を申告 | 評価に組み込み |
| Duolingo | 非公開 | — | 評価指標に入れて、1年で撤回 |
特に参考になるのが DeNA です。理由は2つあります。
1つ目は、組織のレベルをメンバーの構成で決めることです。公式サイトでは、たとえば組織の第3段階の条件を「7割以上が個人レベル2以上、かつレベル3以上が1名以上」としています。管理職からすると、自分だけが上がっても組織のレベルは上がらないので、部下を底上げする動機が生まれます。
2つ目は、個人の最上位に「他者の生産性も上げられる」を置いていることです。上手に使える人ではなく、周りを引き上げられる人を最上位にしています。
05ベンチャーはどう測っているか
ベンチャーの公開事例は、大手とかなり違います。段階と判定方法まで公開している会社はほとんどなく、次の3つのパターンに集まっています。
| 会社 | 規模 | 何をしたか | 処遇 |
|---|---|---|---|
| 令和トラベル | 約100名 | AIを全社員の基礎スキルとし、評価・昇進要件に組み込むと公表。AIエージェントの品質を担う役割も新設 | 評価・昇進要件(基準は非公開) |
| グッドパッチ | 約200名 | CEO が「3月中に Claude Code でアプリを1つ作ってデプロイ」と全事業部門に指示。採用サイトで Lv.1〜5 と四半期表彰を公開 | 表彰金 |
| Ubie | 約220名 | 全職種に Claude Code を広げる前に、2段階の研修を置き、修了で利用できるようにした | 活用度の評価連動は未公表 |
| スイッチメディア | 約30名 | 全員に会社負担で Claude(エンジニアは上位プラン) | なし |
| イグニション・ポイントフォース | 約60名 | 生成AIの有料プランを月3,000円まで会社負担 | 実費補助 |
| Buffer(米国) | 71人 | 全社員に年250ドルのAIツール手当。ツールは本人が選ぶ | 実費補助 |
グッドパッチの号令の結果は、数字で公開されています。185人が217本のアプリを作り、コーディング未経験者の86%がデプロイまで到達しました。「期限を切って、全員に1つ作らせる」は、小さな組織ほど効く打ち手です。
大手との違いを、私たちは次の4点と見ています。
- 測るより配る。全員の顔が見える規模では、段階を判定する手間に見合わない。ツールを配って号令をかけるほうが早い。
- 段階は「処遇の根拠」ではなく「次の一歩の目印」。グッドパッチは等級ではなく表彰で報いている。
- 手当の考え方が違う。大手は認定された人への報酬、ベンチャーの多くは使う費用の実費補助。
- 統制の置き場所が違う。大手は資格や研修の必修化。ベンチャーは利用の入口(Ubie の研修修了)と費用の蛇口(LayerX は経理が利用上限を設定)。
06規模別:どの進め方のパターンが効くか
ここまでの事例をもとに、社員規模ごとに効きそうな進め方のパターンを整理しました。事例からの仮説で、検証済みの基準ではありません。
| 規模 | まずやること | 次にやること | 避けたいこと |
|---|---|---|---|
| 〜10人 | AI前提で働ける人を採り、役割で回す。制度は作らない | 業務ごとに「手順を標準化したか」を数える | 段階表を作る(判定の手間に見合わない) |
| 10〜50人 | 全員にツールを配る(または実費補助)+期限付きの号令 | 作ったものを月1回見せ合う。標準化した手順を共有する | 評価への組み込み(公平性の議論が先に来る) |
| 50〜300人 | 3〜5段階の目印を作り、表彰か手当でつなぐ。利用前の研修 | 評価に「AIで何を良くしたか」の欄を足す | 判定方法を決めないまま処遇に結ぶ |
| 300〜1000人 | 行動指針・予算の上限・利用ルールを仕組みにする | 段階を評価や配置に正式につなぐ。組織のAI成熟度も測る | 号令だけで回す(部門間の温度差) |
| 1000人〜 | 段階・判定方法・手当・昇格要件を明文化する | 部門ごとに具体例を足し、毎年基準を上げる | ツール補助だけで止める |
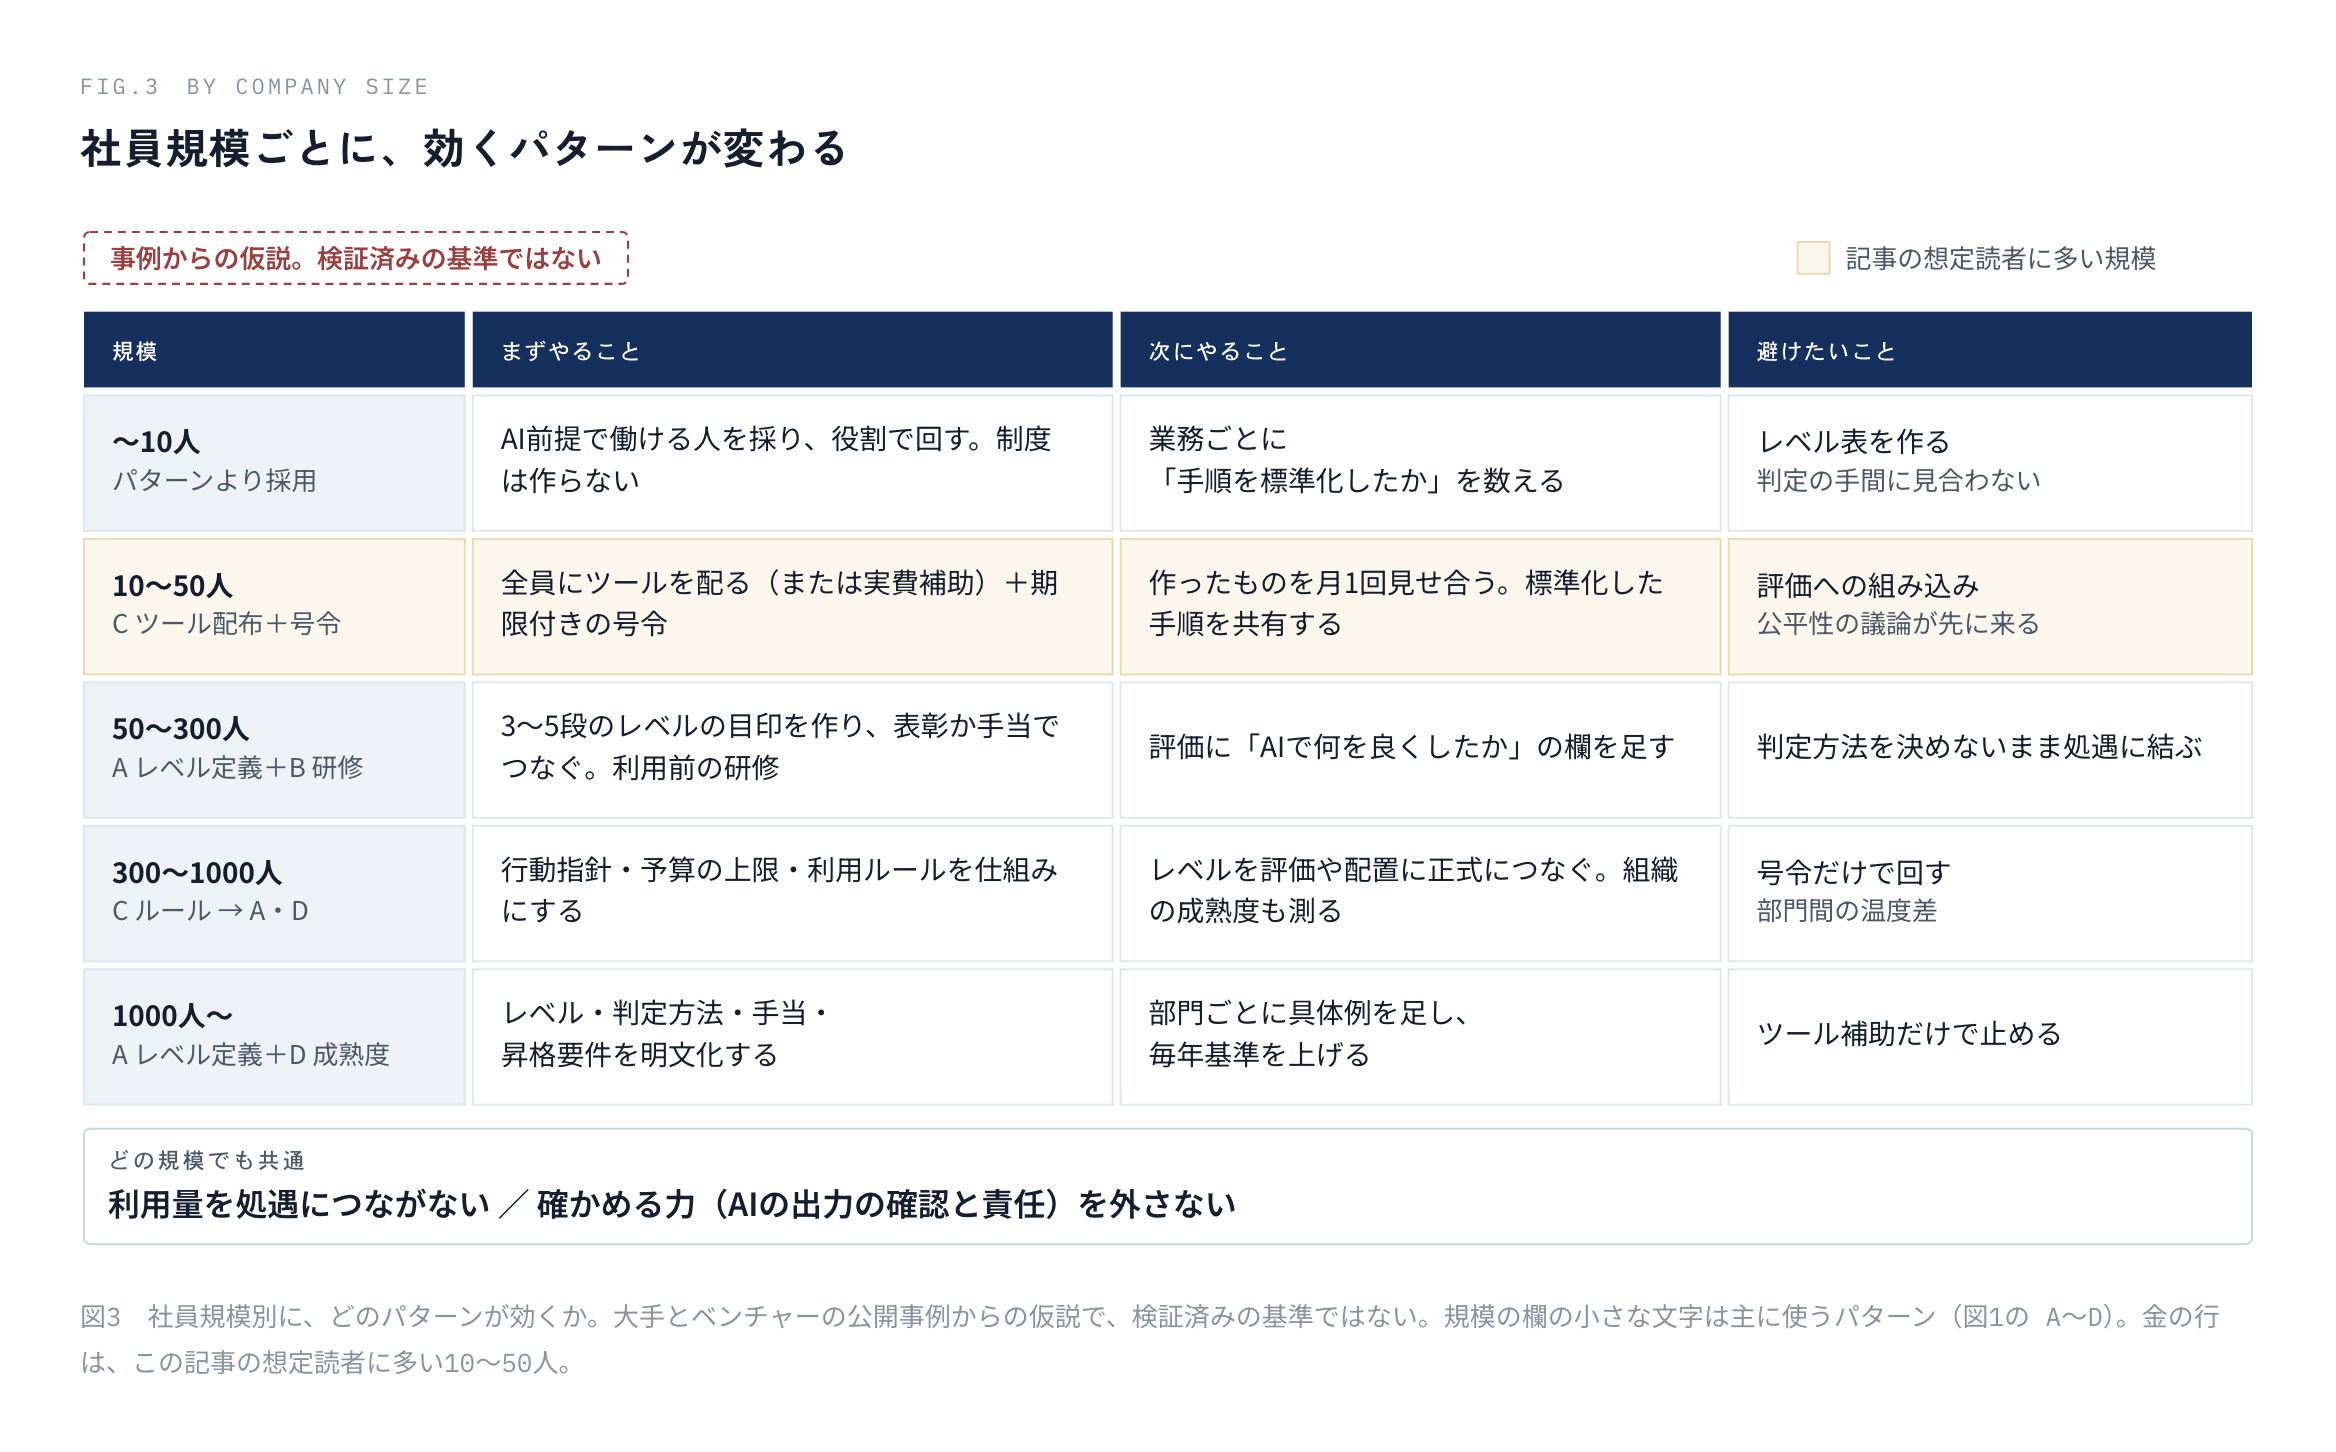
どの規模でも共通するのは、利用量を処遇につながないことと、確かめる力を外さないことの2つです。評価に入れる前に、評価の受け皿である1on1が機能しているかも確認してください。
07Zeyra ならこう測る:3つの評価軸
私たち Zeyra は、AI前提の組織設計を支援する会社です。自社でも AI を前提に業務を組み、毎朝の商談検知から議事録の整理、月次の振り返りまで、AIが自動で回している業務を日々増やしています。その運用の中で、各社の評価軸のいいとこ取りをして、次の3つの評価軸で測ることにしました。
| 評価軸 | 測るもの | 段階 |
|---|---|---|
| 社員のAI活用レベル | 一人ひとりが、どこまで使いこなせるか | Lv0 未着手 → 1 まず使う → 2 毎日の仕事に組み込む → 3 仕組みにして人に渡す → 4 自動化して監督する → 5 社内外に広げる |
| 業務のAI化ステージ | 業務1つ1つが、外に出せる形に近づいたか | S0 手作業 → 1 AIで補助 → 2 手順を標準化 → 3 自動で動く → 4 他社でも使える形 → 5 外部に提供できる |
| 組織のAI成熟度 | 会社の仕組みとして回っているか | O0 未整備 → 1 個人が試している → 2 全員が日常的に使う → 3 業務を作り直し効果を測る → 4 AI前提で運営 → 5 社外に提供 |
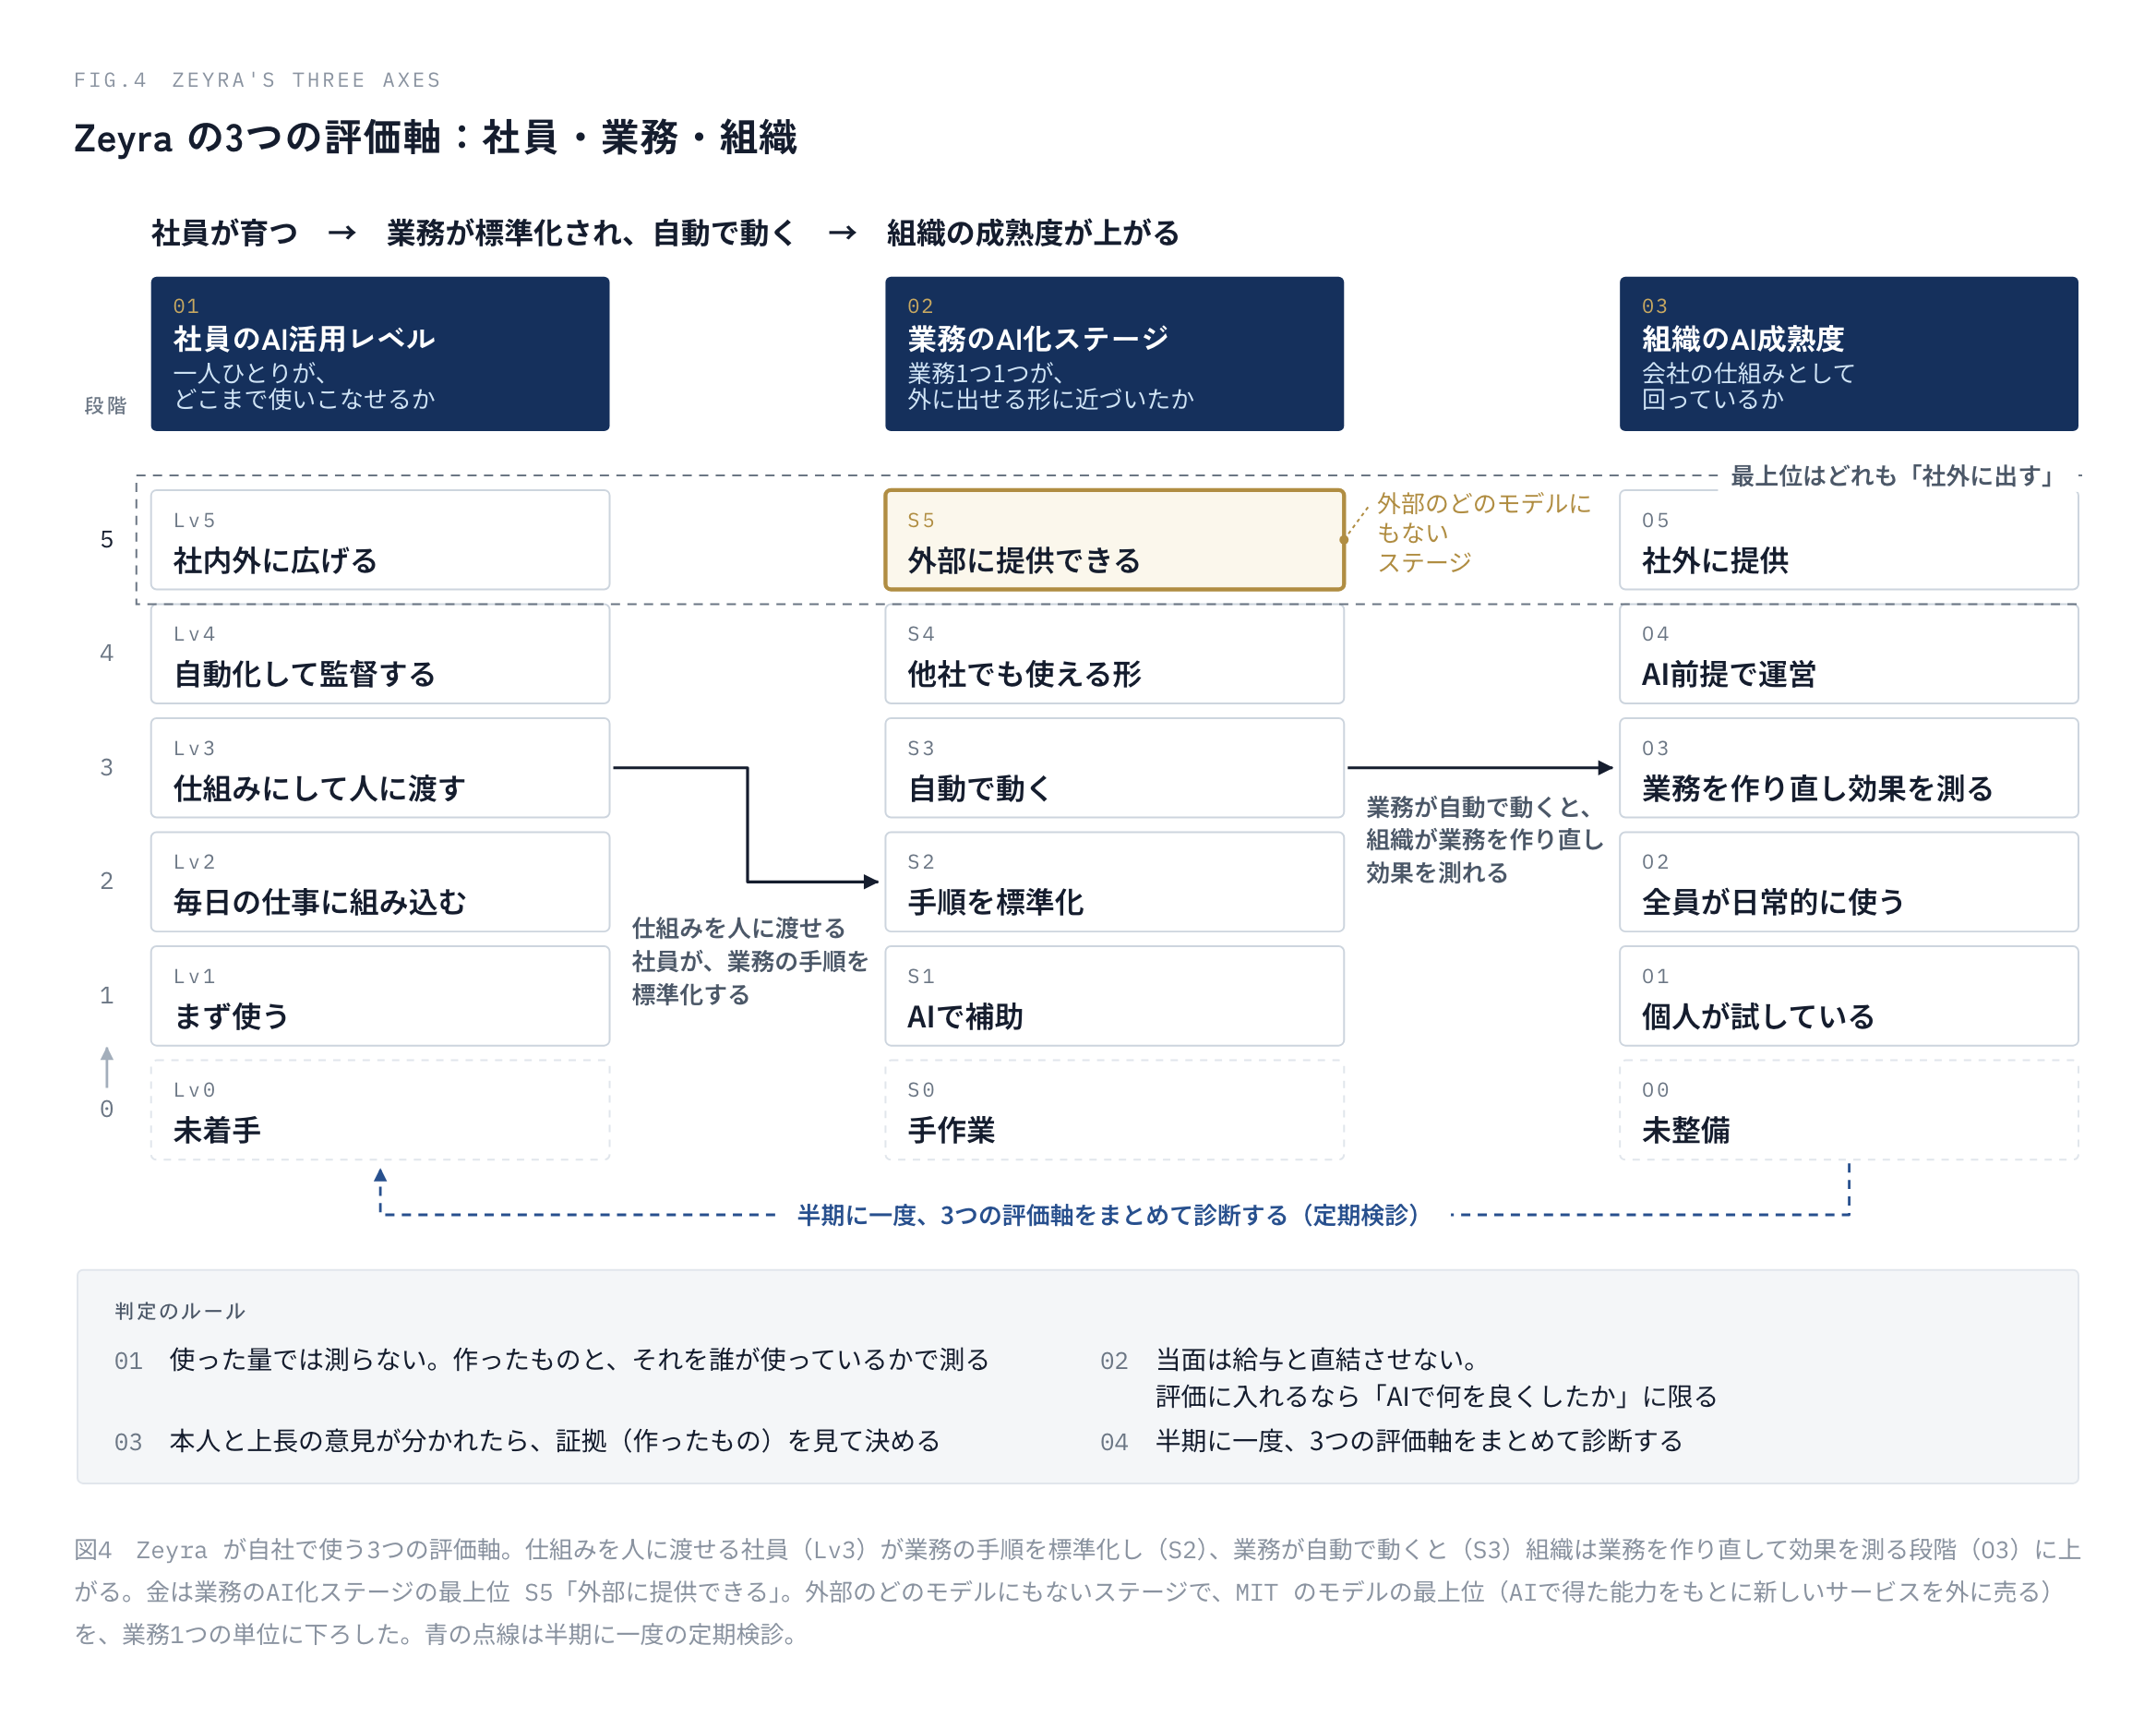
2つ目の「業務のAI化ステージ」は、外部のどのモデルにもそのまま対応するものがありません。MIT のモデルが最上位に置く「AIで得た能力をもとに、新しいサービスを外に売る」を、会社単位ではなく業務1つの単位に下ろしたものです。
なぜ業務単位にしたのか。AIで業務を自動化して終わると、省力化で止まります。その業務を、社名や固有の値を設定に分けて他社でも動く形にし、品質を測れるようにすれば、そのまま他社やお客様に提供できる形になります。1つ1つの業務のゴールを「外部に提供できる状態」に置くと、社内の改善がそのまま事業の種になります。
判定のルールは4つだけです。
- 使った量では測らない。作ったものと、それを誰が使っているかで測る
- 当面は給与と直結させない。評価に入れるなら「AIで何を良くしたか」に限る
- 本人と上長の意見が分かれたら、証拠(作ったもの)を見て決める
- 半期に一度、3つまとめて診断する(定期検診)
この3つの評価軸を、御社の規模と目的に合わせて組み直すのが、組織デザインとして当社がやっている仕事の中身です。
08AIの評価は、まだ「一周目」が終わったところ
ここまで30社以上の評価軸を並べましたが、どれも「正解」ではありません。社員のAI活用を測る取り組みは、2025年に一斉に始まり、2026年にかけて最初の見直しが起きた、まだ一周目が終わったばかりの段階です。
その証拠に、先行した会社ほど、すでに直しています。
| 会社 | 最初に決めたこと | 1年以内に直したこと |
|---|---|---|
| Zapier | 2025年5月に4段階を公開 | 2026年3月、最低ラインを1段引き上げ。単発の利用では合格にならなくなった |
| Duolingo | 2025年4月、AI利用を評価に組み込むと宣言 | 2026年4月、評価指標から外した |
| Shopify | 利用量のランキングを社内に公開 | 2026年6月に廃止。通知型のダッシュボードに変更 |
| サイバーエージェント | エンジニアの段階を毎月測る予定 | 現場の声で、四半期ごとに変更 |
| DeNA | 2025年8月に5段階を導入 | 初回は基準をゆるくし、結果を統計で見てから整える設計。定義に道具の名前を書かない |
AIそのものが半年単位で変わるので、半年前の「上手な使い方」が今は当たり前になります。基準を固定した瞬間に、評価軸のほうが古くなる。だから、評価軸は「決めるもの」ではなく「更新し続けるもの」として設計するのが現実的です。
私たちが自社の評価軸に組み込んでいる更新のルールは3つです。
- 半期に一度、3つまとめて診断し直す。レベルの判定だけでなく、設問そのものが現状に合っているかも見る。
- みんなが上がったら、最低ラインを上げる。Zapier と同じ考え方です。全員が Lv2 を満たすようになったら、Lv2 の条件を今の Lv3 相当に引き上げる。
- 道具の名前は定義に書かず、具体例の欄にだけ書く。Claude や ChatGPT が別のものに変わっても、レベルの定義は残るようにする。
最初から完璧な評価軸を作ろうとすると、作るのに時間がかかり、できたときには古くなっています。小さく決めて、半期ごとに振り返って直す。その繰り返しのほうが、1年後には精度の高い評価軸になっています。
09まとめ:評価軸を作る前に決める3つのこと
段の文言を書く前に、次の3つを先に決めてください。
- 何を測るか。量か、行動か、作ったものか、成果か。量だけを選ぶなら、作ったものとの比で見る。
- 処遇とどうつなぐか。最初は切り離し、判定が安定してからつなぐ。つなぐなら成果で。
- いつ、どう直すか。見直しの周期と、最低ラインを上げる条件を、最初から決めておく。
この3つが決まれば、レベルの数や名前は自社の言葉で書けます。自社の場合はどのパターンから始めるべきかを一緒に見たい場合は、お問い合わせから声をかけてください。準備は不要です。
本記事の数値・制度は2026年10月時点のものです。各社の取り組みは公開情報をもとに Zeyra が整理しました。引用・転載は出典(https://zeyra.co.jp/column/ai-skill-level-framework/)を明記のうえ、ご自由にどうぞ。
御社の規模と目的に合う評価軸と進め方のパターンと、評価への入れ方を、工程に分解してお出しします。準備は不要です。
無料相談(30分)を申し込む出典・参考
- DeNA DARS(段階定義は公式サイトの図版で確認、2026年10月2日)dena.ai/vision/dars/dena.com/jp/news/5279
- Zapier「Raising the AI fluency bar in hiring」zapier.com/blog/raising-ai-fluency-bar-in-hiring
- Anthropic「The AI Fluency Index」academy.claude.com/tutorials/the-ai-fluency-index
- Microsoft Work Trend Index 2026 microsoft.com/en-us/worklab/work-trend-index
- MIT CISR「Enterprise AI Maturity Model」cisr.mit.edu
- Duolingo(二次)Fortune 2026年4月13日 fortune.com
- Shopify(二次)The Pragmatic Engineer blog.pragmaticengineer.com/Meta(二次)Fortune 2026年4月9日 fortune.com
- GMOインターネットグループ group.gmo/news/article/9771
- サイバーエージェント CyberAgent Way「全エンジニアのAI活用レベルを計測」cyberagent.co.jp/way
- NTTドコモソリューションズ nttcom.co.jp/news/pr26030501
- LINEヤフー「AI利用のルール」lycorp.co.jp
- freee Developers Hub「AI開発マニア」developers.freee.co.jp
- メルカリ Engineering Blog engineering.mercari.com
- 令和トラベル reiwatravel.co.jp/news/260515
- グッドパッチ 採用サイト careers.goodpatch.com/about/ai/note(土屋尚史氏)
- Ubie note.com/notty0123
- スイッチメディア prtimes.jp
- イグニション・ポイントフォース note.com/igp_force
- Buffer「AI tools stipend」buffer.com/resources/ai-tools-stipend
- LayerX tech.layerx.co.jp
- Zeyra株式会社の3つの評価軸(社員・業務・組織)と判定のルールは、自社で運用中のものをそのまま掲載(2026年10月時点)